Eine WordPress-Webseite wird langsam. Der Server ist plötzlich dauerhaft ausgelastet. PHP-Prozesse laufen am Limit. WooCommerce reagiert träge. Im schlimmsten Fall erscheinen 502-, 503- oder 504-Fehler. Die erste Vermutung lautet häufig: Zu viele echte Besucher. In der Praxis sieht die Realität zunehmend anders aus.
Traffic Guard: WordPress-Webseiten im Kampf mit Crawler & Bots
Ein erheblicher Teil der Requests kommt heute gar nicht mehr von Menschen, sondern von Crawlern, Suchmaschinen, KI-Systemen, automatisierten Tools und Bots.
Und das Problem dabei ist nicht nur klassischer „Bad Bot Traffic“.
Viele dieser Systeme sind technisch legitim – aber für eine WordPress-Webseite trotzdem extrem teuer.
Sie klicken sich automatisiert durch Seiten, Kategorien, Suchergebnisse, Filter, Archive und Produktvarianten. Sie folgen Links, erzeugen neue URL-Kombinationen und rufen innerhalb kürzester Zeit Inhalte ab, für die ein echter Besucher Stunden oder Tage benötigen würde.
Der Server muss trotzdem jeden einzelnen Request verarbeiten.
Genau hier setzt Traffic Guard an.
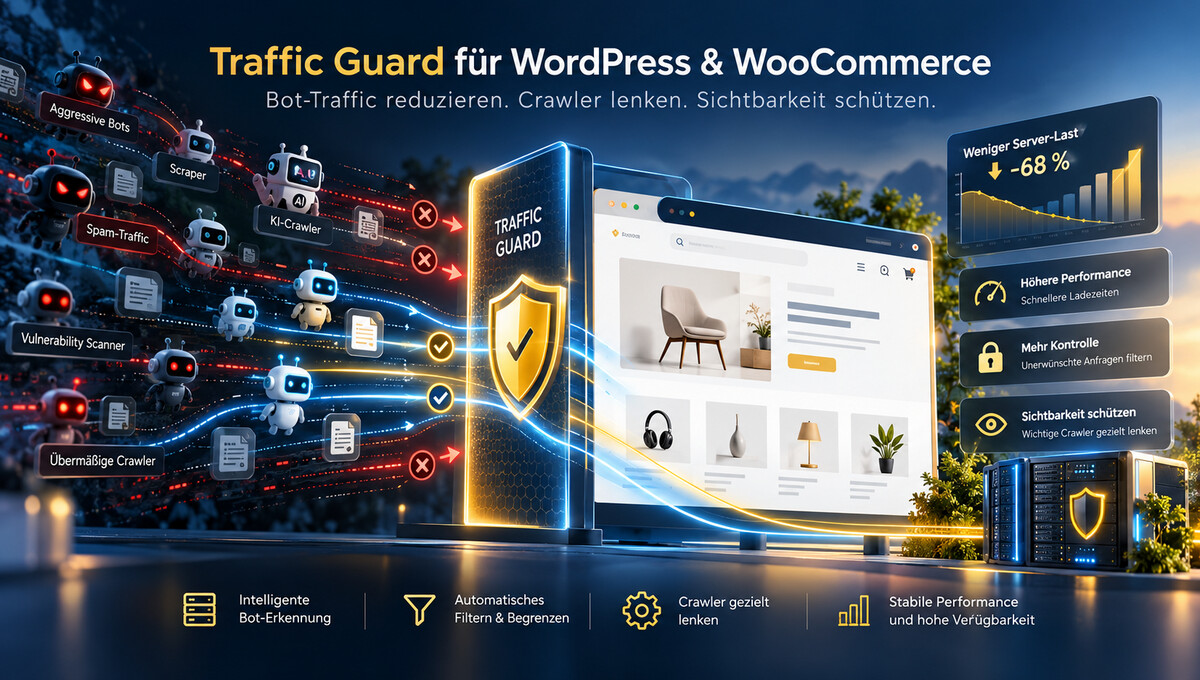
Traffic Guard erkennt Bots, Suchmaschinen und KI-Crawler, priorisiert sinnvolle Zugriffe und begrenzt unnötige Requests – bevor diese WordPress und WooCommerce unnötig belasten.
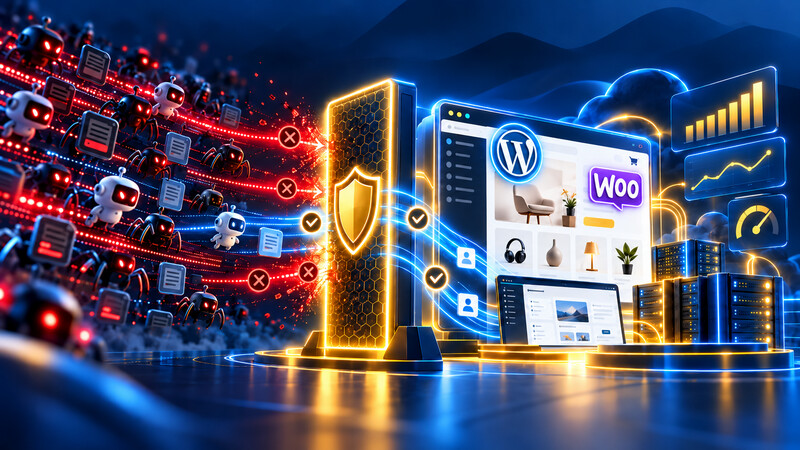
Mit dem Traffic Guard für WordPress & WooCommerce Bot-Traffic reduzieren, Crawler lenken ohne Sichtbarkeit zu verlieren + mehr Sicherheit
Der Traffic Guard für WordPress & WooCommerce erkennt automatisierten Traffic, unterscheidet Suchmaschinen, KI-Crawler und andere Bots und steuert deren Zugriffe gezielt, statt pauschal alles zu blockieren. So können wichtige Crawler weiterhin relevante Inhalte erreichen, während unnötige, aggressive oder wiederholte Zugriffe limitiert, gebremst oder vollständig abgefangen werden.
Das reduziert PHP-, Datenbank- und Serverlast, verhindert unnötige Lastspitzen und sorgt dafür, dass echte Besucher und Kunden mehr Ressourcen zur Verfügung haben. Gleichzeitig verbessert der Traffic Guard die Stabilität und Reaktionszeit der Webseite, reduziert unnötigen Datenverkehr und erschwert automatisierte Scans, Scraping und andere unerwünschte Zugriffe.
Sichtbar/er werden bei Google & Social Media?
In einem kostenlosen Strategiegespräch für datenbasiertes Online-Marketing, decken wir Ihre ungenutzten Potenziale auf, überprüfen ggf. vorhandene Anzeigenkonten, schauen uns das SEO-Ranking und die Sichtbarkeit an und prüfen was zu Ihrem Budget die passende Strategie ist und welche aktiven Maßnahmen zu mehr Anfragen oder Verkäufen führen.
✅ Mehr Sichtbarkeit & Wahrnehmung durch gezielte Platzierung
✅ Mehr Besucher > Interessenten > Kunden > Umsatz
✅ Mit SEA skalierbar Zielgruppe ansprechen
✅ Mit SEO nachhaltig agieren und wachsen
🫵 Maximale Erfolge mit unserer Hybrid-Strategie
💪 Mehr als 15 Jahre Erfahrung branchenübergreifend in über 1.000+ Projekten nachweisbar!
Der entscheidende Vorteil: mehr Performance und mehr Sicherheit, ohne die Sichtbarkeit bei Google, Bing, KI-Suchsystemen und anderen relevanten Crawlern unnötig zu gefährden.
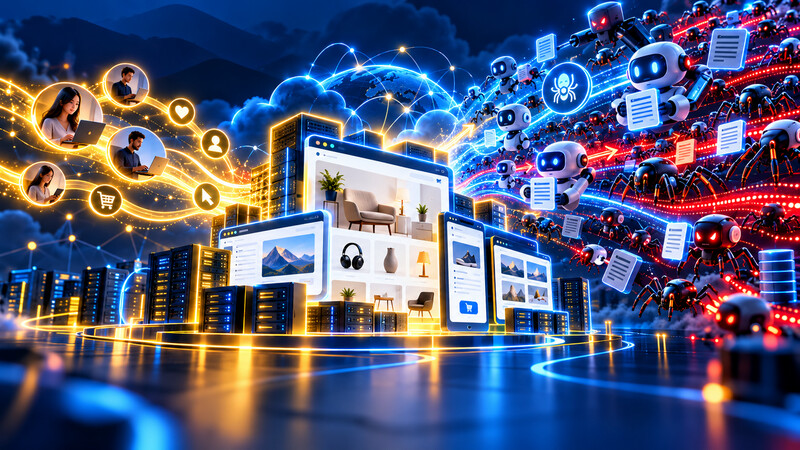
Das Internet bekommt eine zweite Zielgruppe: Maschinen (KI, AI, Bots, Crawler)
Webseiten wurden ursprünglich für Menschen gebaut und von Suchmaschinen durchsucht und sichtbar gemacht.
Ein Besucher öffnet eine Kategorie, betrachtet einige Produkte, liest eine Produktbeschreibung und bestellt vielleicht anschließend.
Ein Crawler und KI-Bot verhält sich völlig anders!
Er kann in wenigen Minuten:
- hunderte Produktseiten aufrufen,
- jede Pagination durchlaufen,
- Filter miteinander kombinieren,
- Suchanfragen erzeugen,
- Parameter-URLs verfolgen,
- Archive und Feeds abrufen,
- strukturierte Daten auslesen und
- dieselben Bereiche regelmäßig erneut besuchen.
Mit klassischen Suchmaschinen-Crawlern existiert dieses Thema schon lange.
Ein passendes Video dazu:
https://youtu.be/fVhx59XqWkA
Durch KI-Suchmaschinen, Large Language Models, Training-Crawler und autonome AI Agents hat sich das Volumen jedoch massiv verändert.
Cloudflare berichtet 2026, dass AI-Agent-Requests innerhalb eines Jahres um mehr als 1.700 % gestiegen sind. Gleichzeitig stammt inzwischen ein enormer Anteil des weltweiten Web-Traffics von automatisierten Systemen.
Crawler sind damit keine Randerscheinung mehr.
Sie sind eine eigene Besuchergruppe.
Und genau so müssen sie behandelt werden.
Mensch v. Maschine: Normale Besucher von KI Crawler Bots Suchmaschinen unterscheiden ist das primäre Ziel womit ALLE Systeme kämpfen.
Warum das gerade bei WordPress und WooCommerce teuer wird (aber auch andere CMS)
Ein Request auf eine statische HTML-Datei ist vergleichsweise günstig.
Bei WordPress sieht das häufig anders aus.
Ein Seitenaufruf kann unter anderem bedeuten:
Webserver → PHP → WordPress → Plugins → Theme → Datenbankabfragen → WooCommerce → Antwort
Bei einem WooCommerce-Shop kommen zusätzlich Produktdaten, Preise, Lagerbestände, Taxonomien, Sessions und zahlreiche weitere Funktionen hinzu.
Besonders problematisch sind URLs, die sich nicht vollständig aus einem Cache beantworten lassen.
Ein Bot benötigt dafür keine besondere Angriffstechnik.
Er muss lediglich genügend davon aufrufen.
Aus einem simplen Crawler wird so ein Lastproblem!
Stellen wir uns einen Shop mit 1.000 Produkten vor.
Für einen Menschen sind vielleicht einige hundert Kategorie- und Produktseiten relevant.
Ein Crawler entdeckt dagegen möglicherweise zusätzlich:
?orderby=price
?orderby=date
?filter_color=black
?filter_size=xl
Suchergebnisse, Paginationen, Tags, Herstellerarchive und weitere URL-Parameter.
Aus einigen tausend sinnvollen Seiten können dadurch sehr schnell zehntausende oder sogar hunderttausende abrufbare URL-Kombinationen entstehen.
Für einen Bot sind das Links.
Für WordPress sind es Requests.
Für den Server sind es CPU-Zeit, PHP-Prozesse und Datenbankabfragen.
Und die KI-Bots kombinieren mit ? dann Filter völlig unnatürlich.
Das Gefährliche daran: Die Webseite sieht gar nicht unbedingt stark besucht aus
Genau deshalb wird dieses Problem häufig falsch diagnostiziert.
Google Analytics oder andere Analytics-Systeme können vergleichsweise wenig echten Besuch anzeigen.
Auf dem Server sieht man gleichzeitig:
- hohe CPU-Auslastung,
- viele PHP-Prozesse,
- hohe Datenbanklast,
- lange Antwortzeiten,
- ungewöhnlich viele Requests,
- 429-, 502-, 503- oder 504-Fehler.
Beides kann gleichzeitig stimmen.
Die Webseite hat wenig menschliche Besucher – aber sehr viel automatisierten Traffic.
Viele Bots führen kein normales Analytics-JavaScript aus. In klassischen Besucherstatistiken tauchen sie deshalb gar nicht oder nur eingeschränkt auf.
Im Server müssen ihre Requests trotzdem verarbeitet werden.
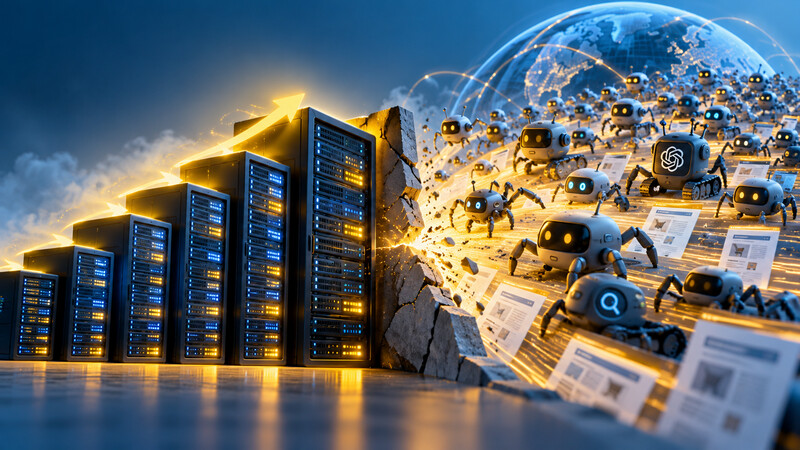
Mehr Serverleistung löst das eigentliche Problem nicht
Natürlich kann man dem Problem zunächst mit mehr Hardware begegnen.
- Mehr CPU.
- Mehr RAM.
- Mehr PHP Worker.
- Ein größerer Server.
Das kann notwendig sein, löst aber die Ursache nicht.
Wenn ein automatisierter Crawler ohne sinnvolle Begrenzung 100.000 unnötige Requests erzeugt, ist die bessere Frage nicht:
Wie viel zusätzliche Serverleistung benötigen wir?
Sondern:
Warum lassen wir überhaupt zu, dass jeder dieser Requests ungefiltert bis zu WordPress und WooCommerce gelangt?
Traffic Guard setzt genau an diesem Punkt an.
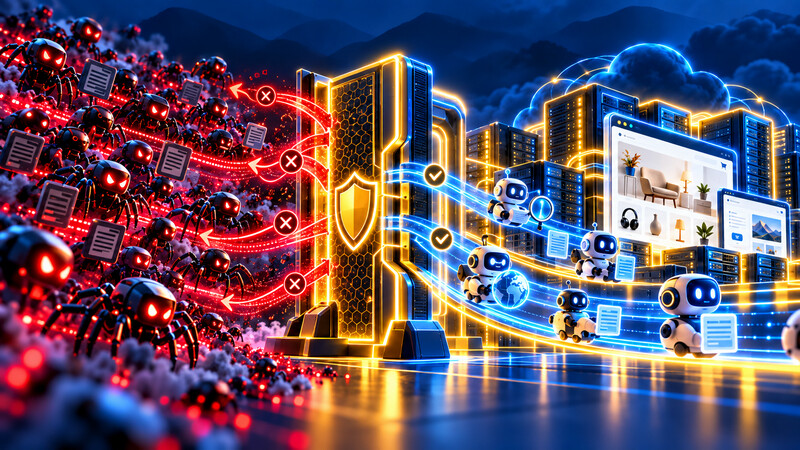
Warum wir nicht einfach alle Bots blockieren
Bots grundsätzlich auszusperren wäre ebenso falsch.
Google muss eine Webseite crawlen können.
Bing ebenfalls.
Auch KI-Suchmaschinen und andere Systeme können für die Sichtbarkeit einer Marke zukünftig relevant sein.
Gleichzeitig gibt es Crawler, deren Nutzen für den Betreiber sehr gering ist, deren Ressourcenverbrauch aber enorm sein kann.
Deshalb unterscheidet Traffic Guard zwischen verschiedenen Arten automatisierten Traffics.
Das Prinzip lautet:
erkennen, einordnen, lenken und limitieren – statt pauschal blockieren.
Eine etablierte Suchmaschine kann anders behandelt werden als ein unbekannter Crawler.
Ein KI-Crawler kann anders behandelt werden als ein normaler Besucher.
Und ein Bot, der innerhalb kürzester Zeit hunderte aufwendige URLs abruft, muss nicht dieselben Freiheiten erhalten wie ein Mensch.
Das Ziel ist nicht weniger Sichtbarkeit
Das ist ein entscheidender Unterschied.
Traffic Guard soll nicht verhindern, dass Inhalte gefunden werden.
Im Gegenteil.
Wichtige Crawler sollen die wichtigen Inhalte weiterhin zuverlässig erreichen können.
Aber ein Crawler benötigt beispielsweise nicht zwangsläufig jede theoretisch mögliche Kombination aus:
Kategorie × Farbe × Größe × Sortierung × Seite × URL-Parameter.
Diese Abrufe können immense Last erzeugen, ohne zusätzlichen Nutzen für die Indexierung zu liefern.
Traffic Guard versucht deshalb, sinnvolles Crawling von unnötigem Ressourcenverbrauch zu unterscheiden.
Und warum nicht einfach vor jede Webseite eine „Bist du ein Mensch?“-Abfrage setzen?
Auch große Schutzsysteme stehen inzwischen vor derselben Herausforderung.
Cloudflare beschreibt seine Challenge Pages selbst als eine der meistgesehenen Oberflächen des Internets. Turnstile und Challenge Pages werden laut Cloudflare zusammen rund 7,67 Milliarden Mal pro Tag ausgeliefert.
Technisch können solche Challenges sehr wirkungsvoll sein.
Aus Sicht des Webseitenbetreibers haben sie aber einen entscheidenden Nachteil:
Der echte Besucher merkt den Schutz.
Er öffnet einen Shop und sieht zunächst:
„Verifying you are human …“
oder muss eine zusätzliche Prüfung durchlaufen.
Cloudflare weist selbst darauf hin, dass Challenge Pages den normalen Request zunächst unterbrechen, während der Browser überprüft wird.
Für besonders kritische Situationen kann das sinnvoll sein.
Als dauerhafte erste Begegnung mit einem Onlineshop möchten wir es jedoch möglichst vermeiden.
Unsere Philosophie bei Traffic Guard ist deshalb eine andere:
Der Mensch soll möglichst gar nicht bemerken, dass Traffic Guard existiert.
Die Arbeit findet im Hintergrund statt.
Automatisierter Traffic wird erkannt und gesteuert, bevor er unkontrolliert Ressourcen verbraucht.
Traffic Guard ist deshalb mehr als ein Bot-Blocker
Ein klassischer Bot-Blocker kennt häufig nur zwei Zustände:
erlauben oder sperren.
Das moderne Web benötigt mehr Abstufungen.
Traffic Guard betrachtet automatisierten Traffic vielmehr als eigene Verkehrsklasse.
Je nachdem, um welchen Client es sich handelt und wie dieser sich verhält, kann der Zugriff unterschiedlich behandelt werden.
Das Ziel:
So viel Zugriff wie sinnvoll. So wenig Last wie notwendig.
Dadurch lassen sich wichtige Systeme weiterhin bedienen, ohne jedem automatisierten Client unbegrenzt Serverressourcen zur Verfügung zu stellen.
Das verbessert nicht nur die Performance
Weniger unnötige Requests wirken sich auf mehrere Bereiche gleichzeitig aus.
1. Weniger Serverlast
Requests, die WordPress gar nicht erst vollständig verarbeiten muss, benötigen keine teuren PHP- und Datenbankressourcen.
Gerade bei WooCommerce kann das einen erheblichen Unterschied machen.
2. Stabilere Antwortzeiten
Wenn automatisierte Systeme nicht mehr sämtliche verfügbaren Ressourcen beanspruchen, bleiben mehr Kapazitäten für echte Kunden.
Ein Mensch, der ein Produkt kaufen möchte, sollte schließlich Priorität vor einem Bot haben, der gerade die 800. Filterkombination crawlt.
3. Weniger Lastspitzen
Crawler arbeiten häufig in Wellen.
Innerhalb weniger Minuten können tausende Requests entstehen.
Eine kontrollierte Begrenzung glättet solche Spitzen.
4. Weniger unnötiger Datentransfer
Auch gecachte Seiten sind nicht kostenlos.
Requests erzeugen Netzwerkverkehr, Logeinträge und Infrastrukturkosten.
5. Mehr Sicherheit
Traffic Guard ersetzt keine Firewall und kein Security-Plugin.
Trotzdem ist kontrollierter automatisierter Traffic ein wichtiger Bestandteil einer guten Sicherheitsarchitektur.
Denn dieselben Mechanismen, mit denen harmlose Crawler automatisiert Webseiten durchsuchen, werden auch für:
- Schwachstellen-Scans,
- Enumeration,
- Credential Stuffing,
- Scraping,
- Spam und
- automatisierte Angriffe
verwendet.
Ein System, das automatisierten Traffic erkennt und begrenzen kann, reduziert damit gleichzeitig die frei verfügbare Angriffsfläche.
Siehe auch unseren Artikel: Mehr WordPress Sicherheit und WordPress WooCommerce sicher machen:
WordPress Sicherheit erhöhen, Schutz vor Hackern und Sicherheitslücken
robots.txt allein reicht dafür nicht
Eine robots.txt ist eine wichtige Information für kooperative Crawler.
Sie ist aber keine Zugangskontrolle.
Ein Bot kann sich daran halten.
Er muss es nicht.
Außerdem löst eine robots.txt ein weiteres Problem nicht:
Selbst ein grundsätzlich erwünschter Crawler kann durch zu hohe Crawl-Geschwindigkeit unnötige Last erzeugen.
Traffic Guard kontrolliert deshalb nicht nur, wer auf eine Webseite zugreifen möchte, sondern auch, wie dieser Zugriff stattfindet.
Besonders relevant für WooCommerce
Onlineshops sind für automatisierte Systeme besonders attraktiv.
Sie enthalten sehr viele strukturierte Informationen:
Produkte, Preise, Marken, Kategorien, Bilder, Verfügbarkeiten und Varianten.
Gleichzeitig gehören WooCommerce-Shops zu den WordPress-Systemen, bei denen ein Request besonders viel serverseitige Arbeit auslösen kann.
Das macht sie zu einem perfekten Ziel für Crawler – und gleichzeitig besonders empfindlich gegenüber schlecht kontrolliertem Crawling.
Traffic Guard wurde deshalb nicht nur für klassische WordPress-Webseiten gedacht, sondern insbesondere auch für die Anforderungen von WooCommerce-Shops.
Eine moderne Webseite muss zwei Zielgruppen bedienen
Das Web verändert sich.
Neben Menschen greifen immer mehr Maschinen auf Webseiten zu.
Suchmaschinen.
KI-Systeme.
AI Agents.
Crawler.
Monitoring-Systeme.
Scraper.
Automatisierte Tools.
Diese Entwicklung lässt sich nicht sinnvoll mit der einfachen Regel beantworten:
Bots an oder Bots aus.
Webseiten brauchen eine intelligente Verkehrskontrolle.
Menschen sollen sich frei und ohne störende Sicherheitsabfragen bewegen können.
Wichtige Suchmaschinen sollen Inhalte zuverlässig indexieren können.
Sinnvolle KI-Systeme sollen kontrolliert auf Inhalte zugreifen können.
Und automatisierte Systeme dürfen nicht unbeschränkt Serverressourcen verbrauchen.
Genau dafür entwickeln wir Traffic Guard für WordPress und WooCommerce.
| Klassischer Ansatz | Traffic Guard |
|---|---|
| Bot komplett blockieren | Bot erkennen und gezielt steuern |
| CAPTCHA/Challenge für Besucher | Schutz möglichst unsichtbar |
| Erst reagieren, wenn Last entsteht | Requests frühzeitig begrenzen |
| Gute und schlechte Bots gleich behandeln | Traffic differenzieren |
| Sichtbarkeit eventuell beeinträchtigen | relevante Crawler weiter zulassen |
Crawler erkennen. KI und Suchmaschinen unterscheiden. Traffic lenken. Requests limitieren.
Und vor allem:
Serverressourcen wieder für diejenigen reservieren, für die die Webseite eigentlich gebaut wurde – echte Besucher und Kunden.
Empfehlung jetzt Traffic Guard installieren:


 EN